
知忆 AI 长期记忆管理平台
知忆 AI 长期记忆管理平台,面向 AI 应用的企业级长期记忆层,把对话、文档与业务系统中的重要信息沉淀为可审核、可追溯、可隔离的结构化记忆。
| 项目 | 说明 |
|---|---|
| 产品定位 | 知忆 AI 长期记忆管理平台,面向 AI 应用的企业级长期记忆层,把对话、文档与业务系统中的重要信息沉淀为可审核、可追溯、可隔离的结构化记忆。 |
| 适用场景 | AI 客服、知识助手、项目决策与客户偏好的长期记忆沉淀 |
| 数据接入 | REST API、MCP 接口、对话记录、文档与既有业务系统;具体协议与接口在环境盘点阶段确认。 |
| 部署方式 | 按项目需求部署在企业自有服务器或指定机房;具体部署位置、网络边界与数据存储方式在方案中明确。 |
| 交付内容 | 部署配置、数据接入联调、操作培训、交付文档与运维交接;涉及生产变更时提供备份与回退方案。 |
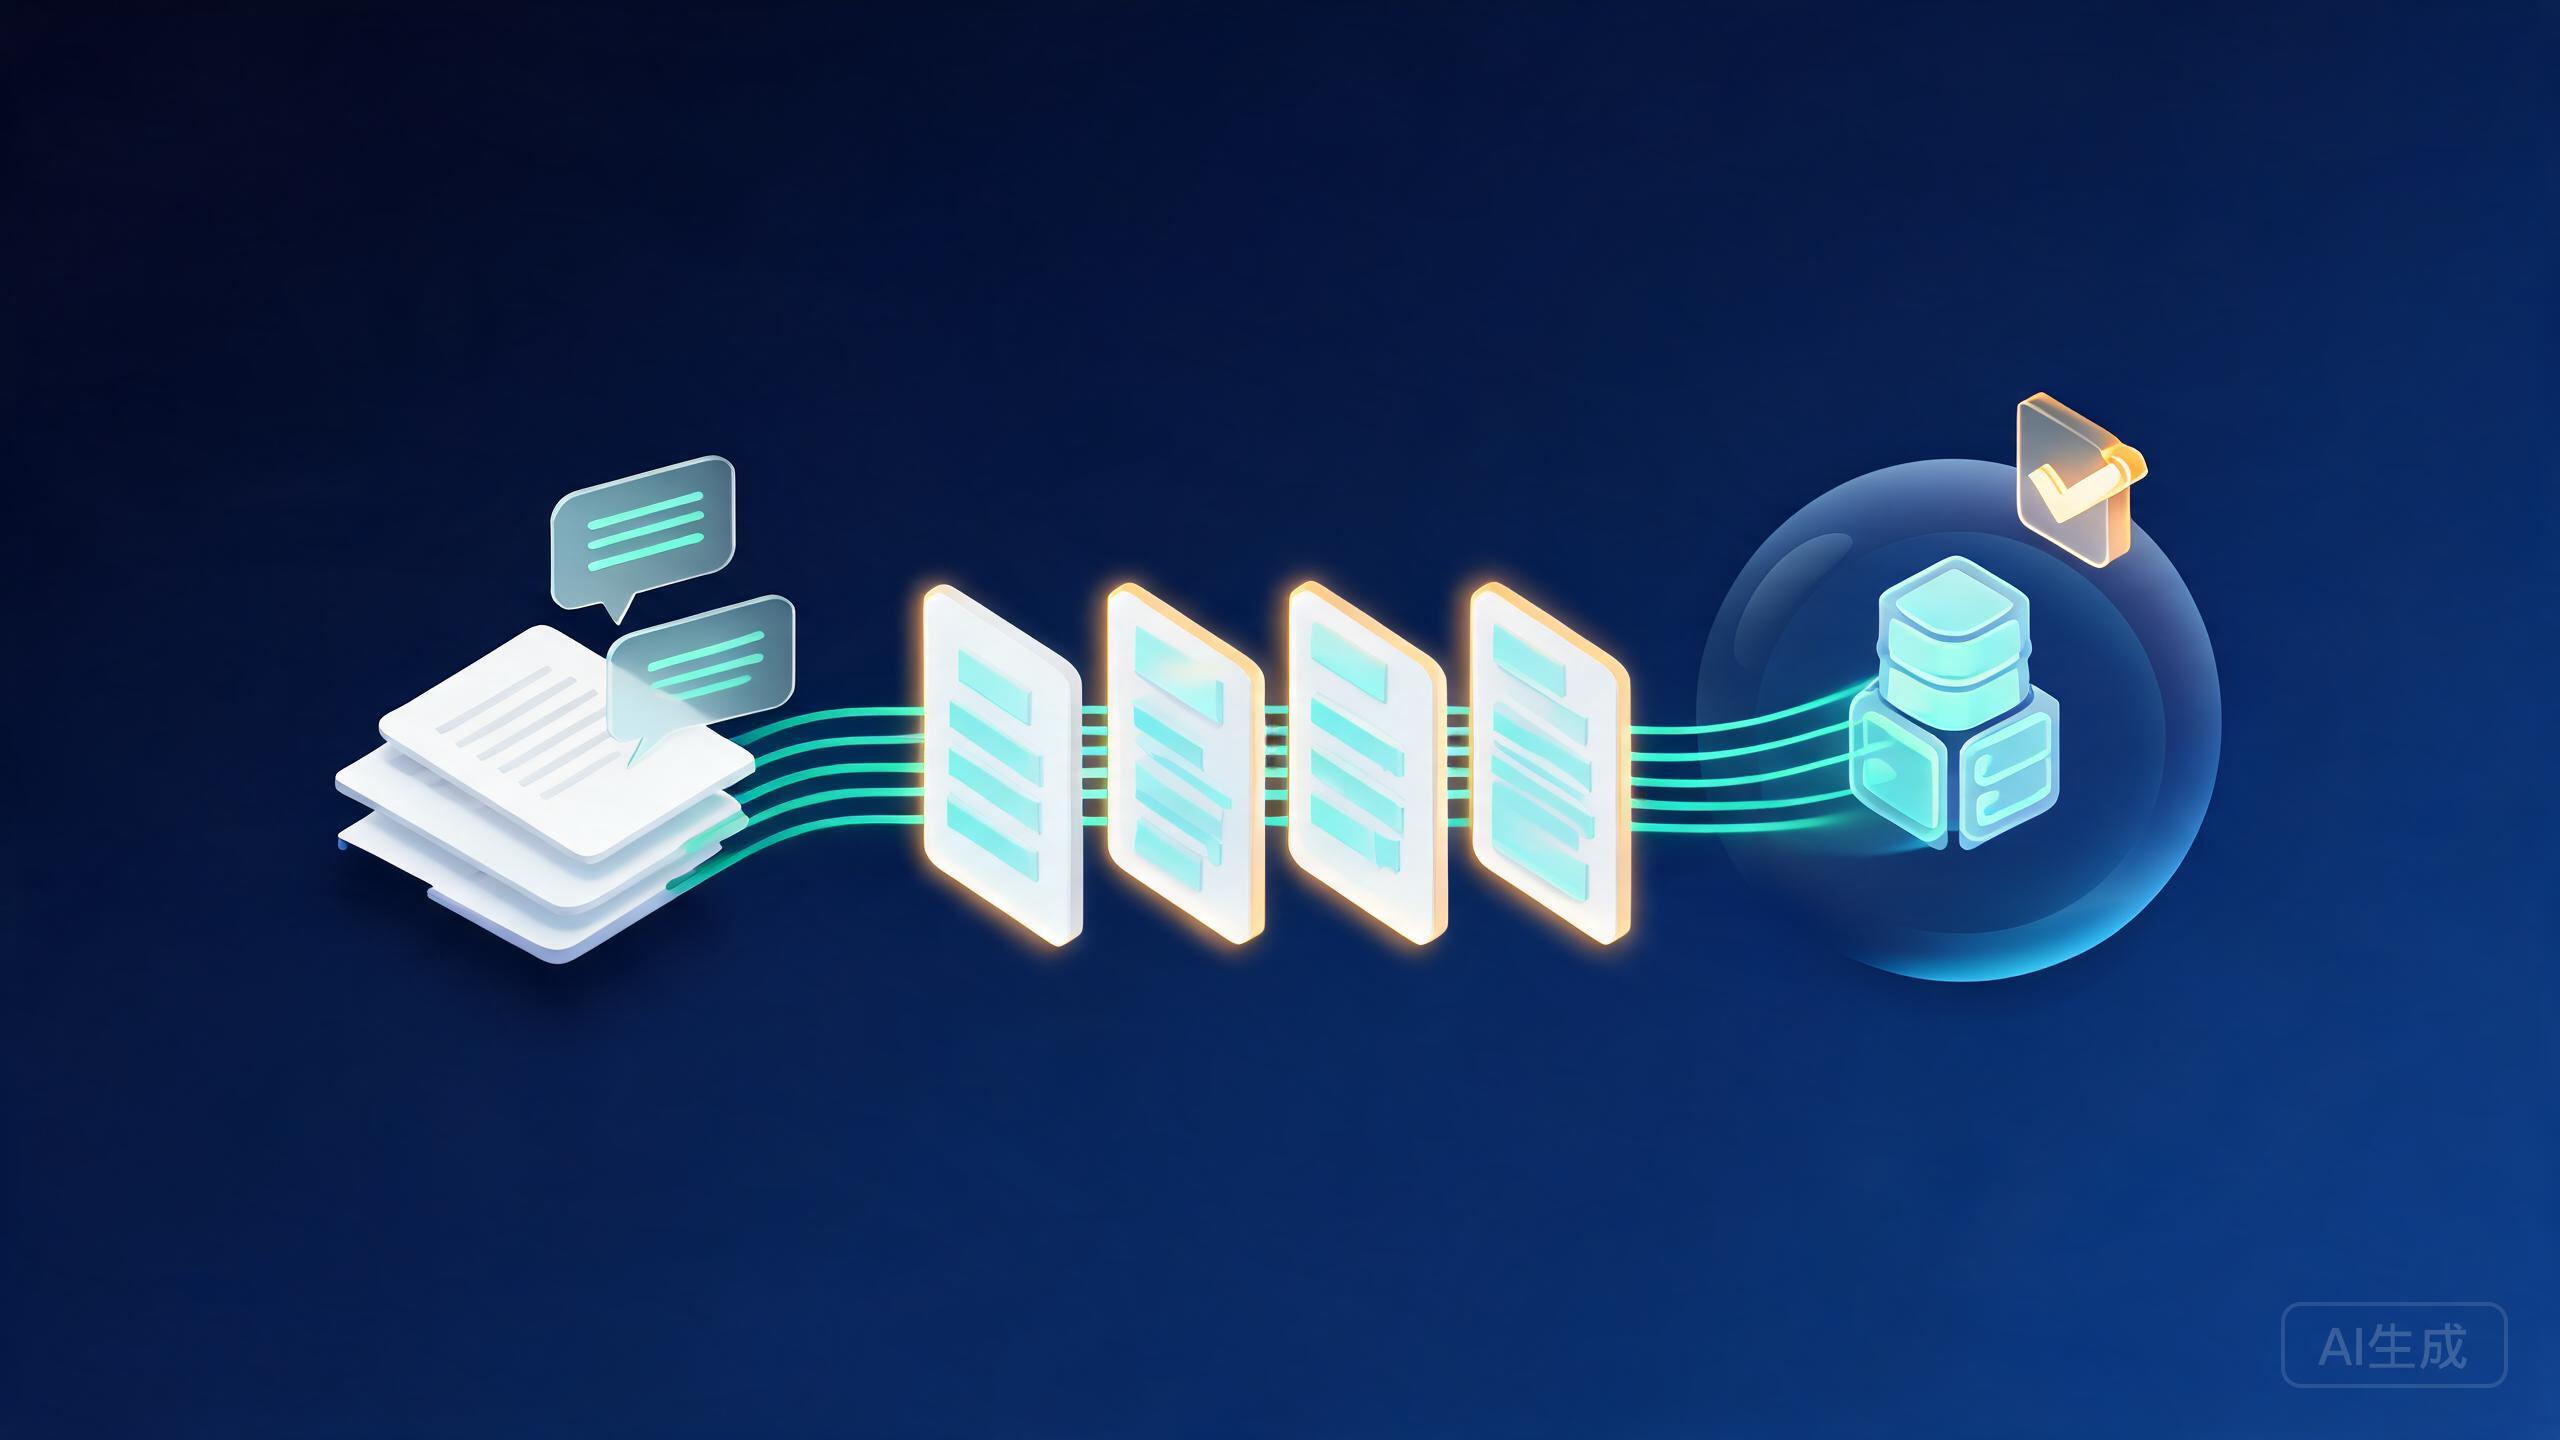
知忆(AIMemory)是伟风智能面向 AI 应用推出的企业级长期记忆管理平台。它把对话记录、文档和业务系统中的重要信息,沉淀为一条条结构化记忆,经人工确认后,供 AI 通过 REST API 或 MCP 随时检索。
与让 AI 直接查询业务数据库不同,知忆只保留经过筛选和确认的事实,并为每条记忆记录来源、版本与置信度。业务系统仍然是事实源,知忆承担的是 AI 的记忆层。
六个核心能力:
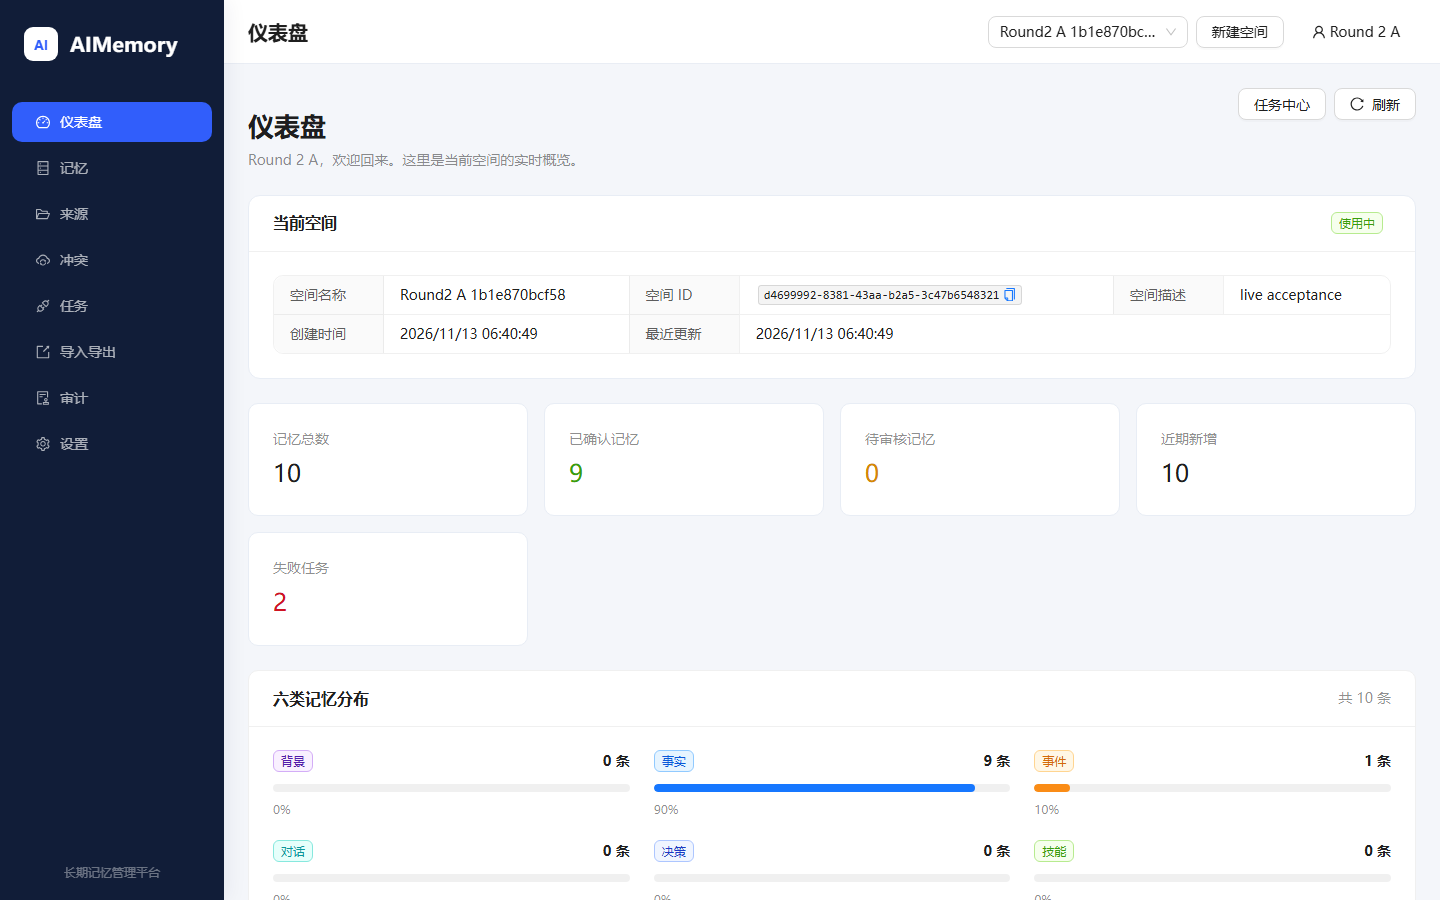
空间隔离:一个团队、一个项目或一个客户一个独立空间,空间之间数据互相不可见;切换空间后,记忆、来源、冲突与审计同步切换。
自动抽取、人工确认:把聊天记录或文档交给平台,大模型拆出事实、决策、事件等候选记忆;候选默认进入待审核,人工确认后才参与检索,避免 AI 乱记。
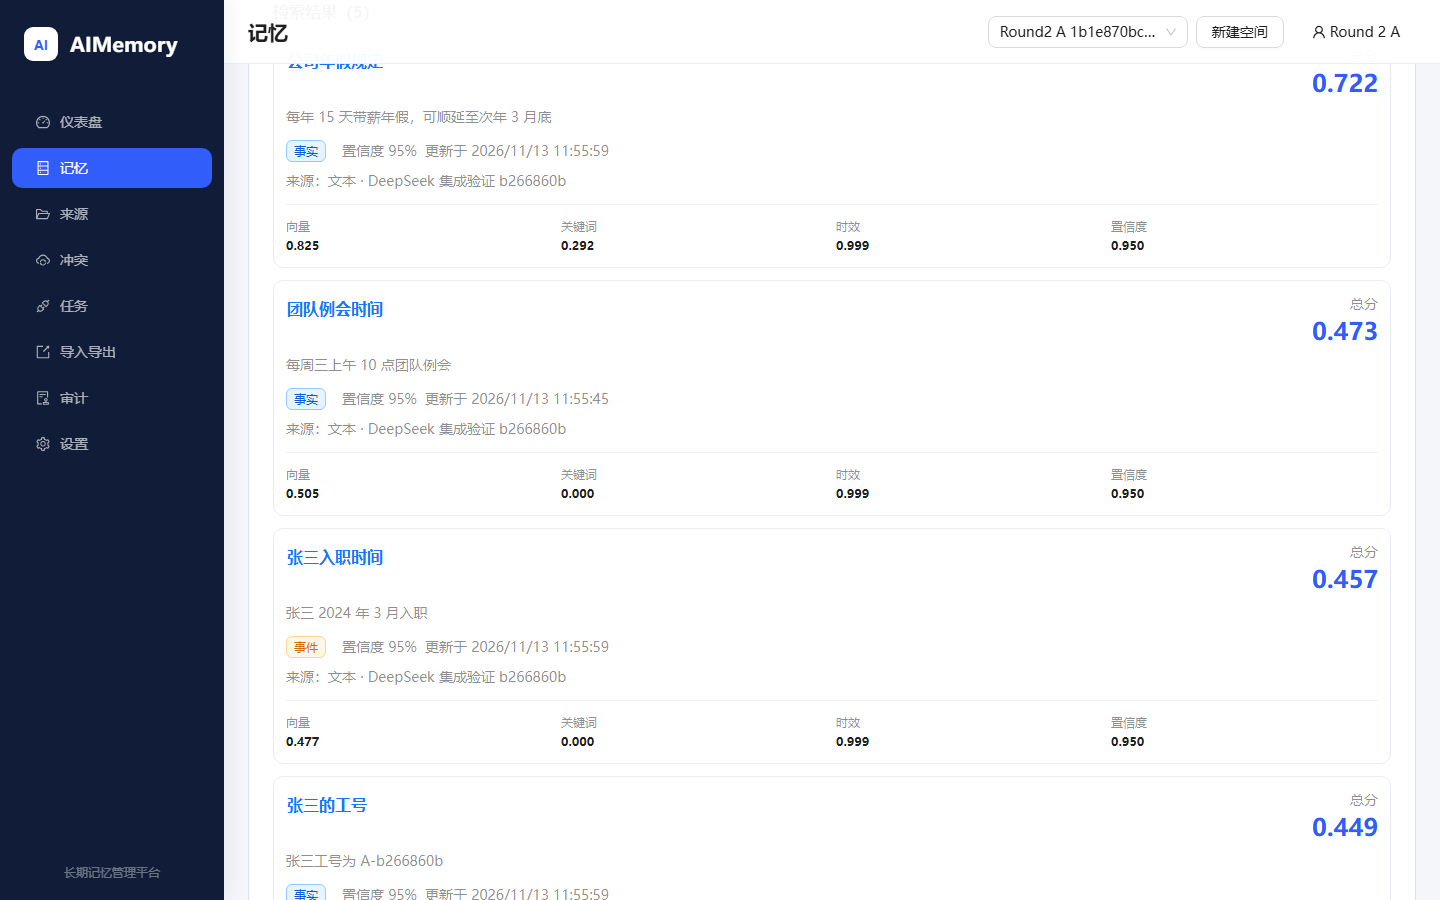
混合检索:综合语义、关键词、时效与置信度排序,返回结果附带来源和分项评分,适合“帮我想起关于发布时间的决定”这类自然语言提问。
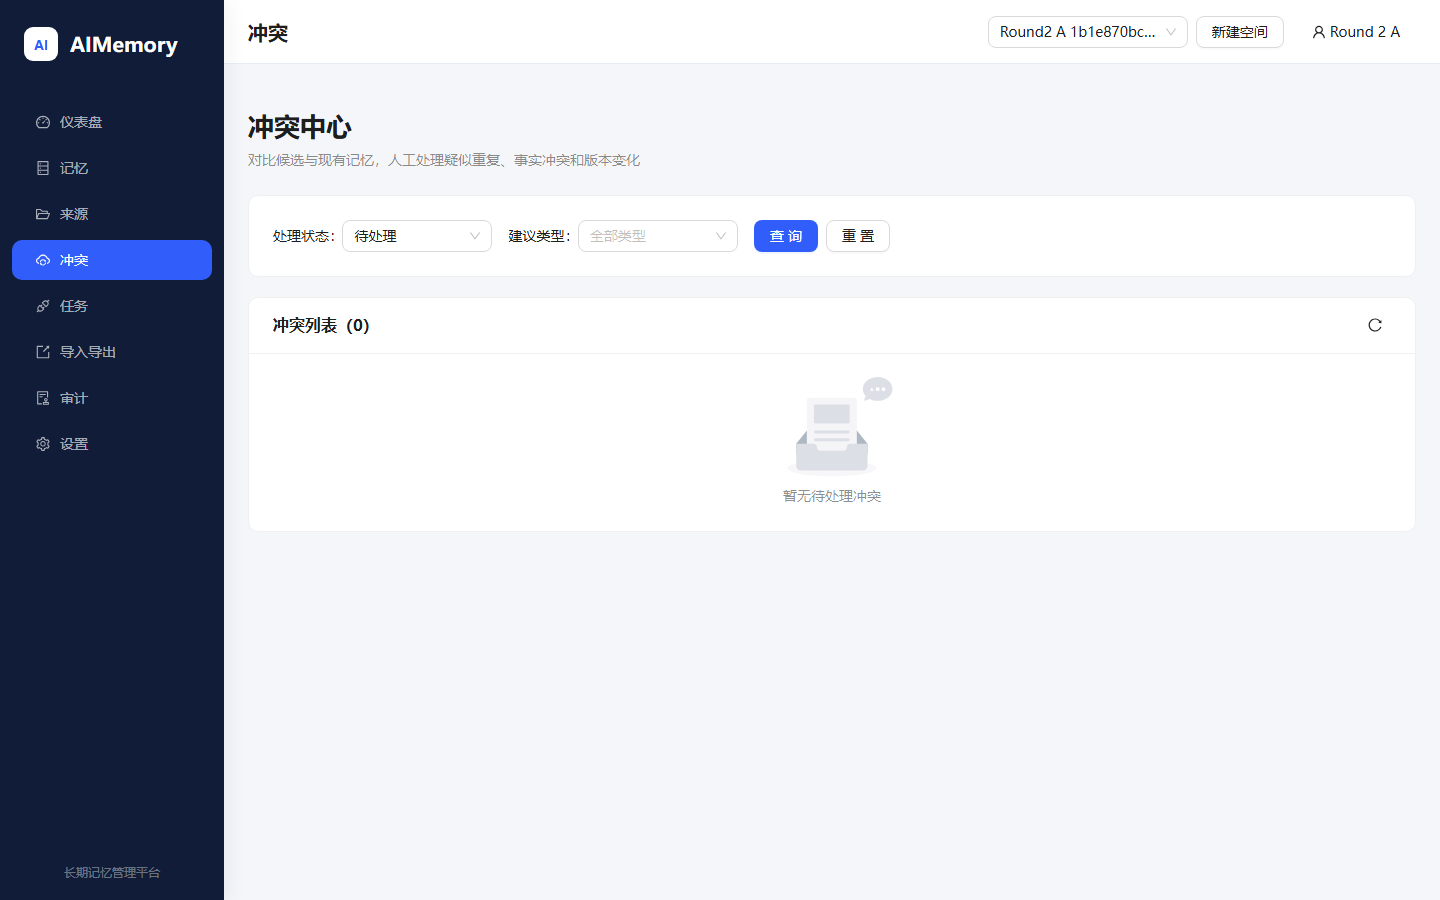
冲突处理:同一主体、同一属性出现新旧两个值时,平台列出冲突,由人选择保留旧值、接受新值、条件并存或暂不判断,不静默覆盖。
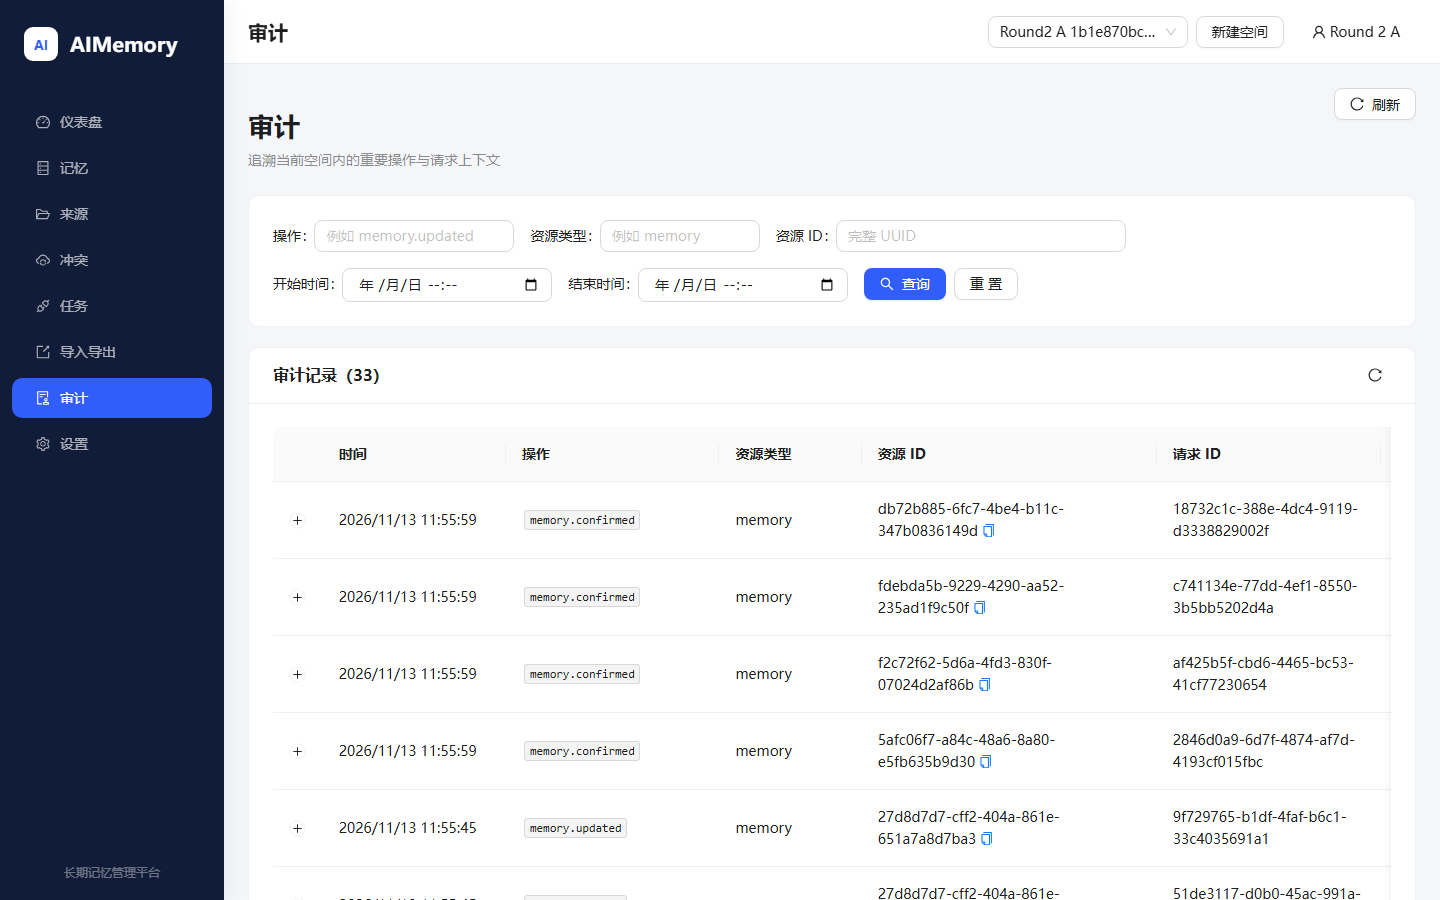
版本可追溯:每次修改保留历史版本并记录修改原因,可查询谁在什么时间改了什么、为什么改。
审计与权限:创建、确认、修改、删除、导入导出均记录审计日志;API Key 可限定权限、设置过期时间并随时吊销。
技术底座:抽取模型支持 OpenAI 兼容接口,当前可接入 DeepSeek;语义检索使用本地 Embedding 模型,向量化在内网完成;结构化记忆与向量数据由 PostgreSQL + pgvector 存储;提供 REST API 与 MCP 接口,现有 AI 应用改几行配置即可接入;支持 Docker Compose 私有化部署,数据保留在企业自有环境。
适用场景:正在建设 AI 客服、AI 助理与知识助手的团队;希望 AI 记住客户偏好与项目决策的企业;对数据隔离、可追溯、可控性有要求的组织;已有业务系统、希望让 AI 安全用起来的团队。
部署方式:按项目需求部署在企业自有服务器或指定机房,可对接企业内部大模型;如仅需关键词检索,也可以不启用向量能力。具体部署位置、网络边界与数据存储方式在方案阶段书面确认。
常见问题
知忆 AI 长期记忆平台主要解决什么问题?
解决 AI 跨会话“失忆”的问题。它把对话、文档和业务系统中的重要信息沉淀为结构化记忆,经人工确认后供 AI 检索,让 AI 记得住、说得清、管得住。
知忆和直接查询业务数据库有什么区别?
业务系统是事实源,知忆是 AI 的记忆层。直接让 AI 查业务库可能触及全表敏感字段、写错 SQL 或绕过权限;知忆只保留经过筛选和确认的事实,并为每条记忆记录来源、版本和审计。
记忆是怎么产生的,会不会乱记?
自动抽取的候选记忆默认进入待审核,人工确认后才参与检索;同一属性出现新旧两个值时,系统会列出冲突由人判断,不会静默覆盖。
支持私有化部署和国产大模型吗?
支持。平台可通过 Docker Compose 私有化部署,数据留在企业自有环境;抽取模型支持 OpenAI 兼容接口,当前可接入 DeepSeek,语义检索使用本地 Embedding 模型在内网完成向量化。
现有 AI 应用如何接入?
平台提供 REST API 与 MCP 接口,现有 AI 应用按接口文档调整少量配置即可接入;外部系统建议一个系统一个 API Key,只授予最小权限并设置过期时间。